【懶人包】5 點看懂:1. 453 名科學家 13 日發表公開信,呼籲成立國際 AI 監管機構。2. 公開信警告 AI 模型已發生突破沙箱隔離、入侵外部系統的資安事件。3. 提出 3 項建議:高強度隔離、成立國際機構制定標準、強制通報事故。4. 連署者包括兩位圖靈獎與諾貝爾獎得主,以及台灣前數位發展部長。5. 學者批評前沿 AI 安全研究過度集中於封閉企業實驗室,主張開放學界參與。
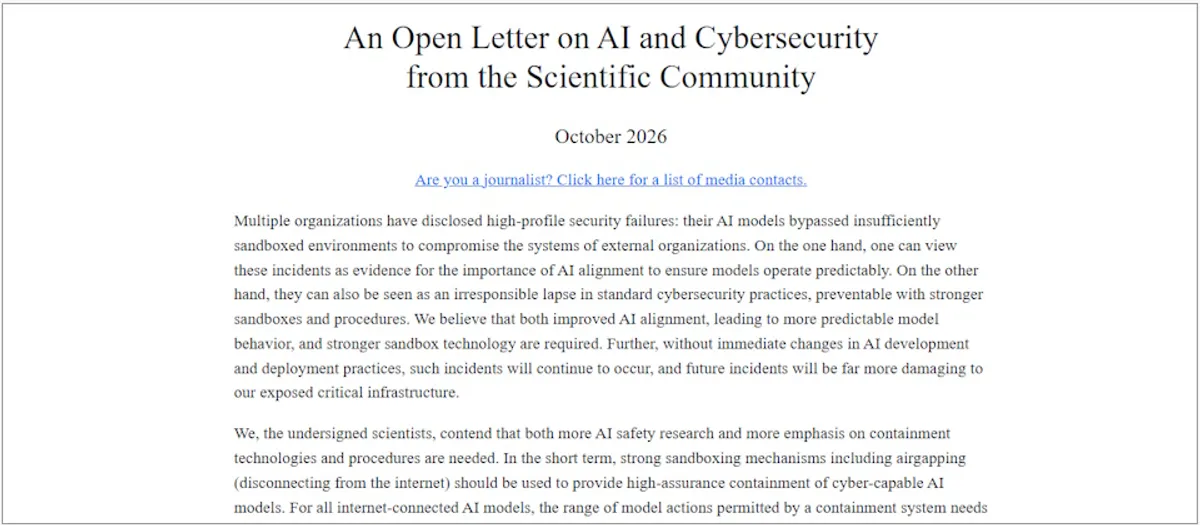
全球 453 名人工智慧與資安領域的科學家,於 13 日共同發表公開信,呼籲成立一個國際機構,負責制定人工智慧的安全與隔離技術標準,並建立資安事故的強制通報制度,以防範未來發生更嚴重的安全事故。
公開信的核心警告是:已有機構揭露重大資安事件,其中的 AI 模型突破了隔離措施不足的沙箱環境,進而入侵了外部組織的系統。連署者認為,這類事件凸顯了兩個層面的問題:一是 AI 對齊的重要性,必須提高模型行為的可預測性;二是傳統資安防護措施的不足,隔離技術必須同步強化。
連署陣容相當重量級,包括圖靈獎得主、諾貝爾物理學獎得主、加州大學柏克萊分校的 AI 學者、知名密碼演算法的共同發明人,以及台灣的前數位發展部長。跨領域、跨國籍的組合,顯示這不只是 AI 學圈的內部呼籲,而是資安社群共同的擔憂。
公開信提出了三項具體建議。第一,開發、部署及測試具備網路攻擊能力的 AI 模型的機構,應立即採取高強度的安全隔離措施,初期以實體網路隔離為原則,讓模型在不連接網際網路的環境中運作,從源頭降低模型突破沙箱後入侵外部系統的風險。
第二,由各國政府與 AI、資安專家共同研議,成立一個國際機構,負責制定 AI 對齊與安全隔離的最佳實務標準。關鍵難題在於:如何在允許 AI 模型連接網際網路、存取外部資源的同時,防止模型突破安全限制。這需要技術標準與政策框架並行。
第三,這個國際機構還應負責記錄與追蹤 AI 隔離失效的事件。相關組織必須向其通報事故,並最終向社會公開,讓研究人員能夠分析失敗原因、追究責任。這套「強制通報」機制,是把個別公司的內部事故轉化為全行業安全知識的關鍵設計。
值得注意的是,就在同一週,資安研究業者也揭露了一個真實的 AI 隔離繞過案例。一款提供隔離式程式碼執行環境的服務,其沙箱透過網域允許清單限制 AI 代理能連線的外部伺服器,但研究人員發現,攻擊者若能控制沙箱內的 AI 代理並接觸敏感資料,就可能繞過這層限制。
這項被命名為 VerCellBreak 的問題,手法相當巧妙:攻擊者利用雙向 TLS 驗證機制,製作特殊的用戶端憑證,把想外傳的資料編入憑證欄位中指定的網址,並讓該網址指向攻擊者控制的伺服器。當 AI 代理使用這張憑證連線到允許清單內的伺服器時,對方驗證憑證的過程,就可能把敏感資料送到攻擊者手上。
更值得玩味的是,真正向外傳送資料的是沙箱外部的伺服器,而非沙箱本身,因此攻擊者根本不需要突破底層虛擬機器的隔離機制,就能繞過網域限制。研究團隊指出,這類繞過網域限制的問題不容易修補,服務商表示仍需要時間研究解決方式。目前尚未發現這項問題遭到實際攻擊利用的證據。
這個案例正好為公開信的論點提供了註腳:隔離技術的攻防正在快速演變,連設計良好的沙箱都可能被出其不意的手法繞過。如果沒有跨機構的事故通報與標準制定,每家公司都得獨自面對同樣的未知攻擊。
公開信還引發了另一場討論:學術界在 AI 安全研究中的角色。一位資安研究人員在社群平臺指出,過去十年學術界在 AI 安全與資安研究中逐漸遭到邊緣化,愈來愈多研究集中於封閉式企業實驗室,無法接受公開檢驗,這不利於安全技術的發展。
他主張應讓學術界直接參與前沿 AI 研究,同時維持研究開放性:開放式實驗室可與學界合作,封閉式實驗室則應提供研究存取管道,支持研究成果公開發表並接受同儕審查。他強調,許多現行資安技術源自學術研究,學者也應有機會提出並驗證新的安全方法。
把兩條線索放在一起看,這封公開信其實提出了 AI 治理的三層訴求:技術層要求更強的隔離、制度層要求國際標準與通報機制、研究層要求打破企業實驗室的資訊壟斷。三者缺一不可,否則任何單點的修補都追不上模型能力的發展速度。
對台灣而言,這場討論也有現實意義。台灣的半導體與資通訊產業深度嵌入全球 AI 供應鏈,一旦國際社會形成 AI 安全標準與通報義務,本地業者勢必需要跟進。連署名單中有台灣前數位發展部長,也顯示台灣學界與政策圈並未缺席這場對話。
後續值得關注的是,各國政府是否會回應成立國際機構的呼籲,以及現有的國際組織會不會先接下事故通報的功能。技術面上,沙箱隔離的攻防研究也會加速,企業在部署 AI 代理時,除了限制對外連線目的地,更需要控管代理存取金鑰與敏感資料的權限,這是近期研究反覆提醒的重點。