英特爾在 OCP 2026 全球大會上,公布代理式 AI 基礎架構的最新進展。重點包括 GPU D 系列的技術細節,以及搭載 Xeon 處理器的新一代機櫃設計,搭配支援異質運算的開放式軟體與硬體標準,目標是讓企業資料中心能更好地支援代理式 AI 的工作負載。
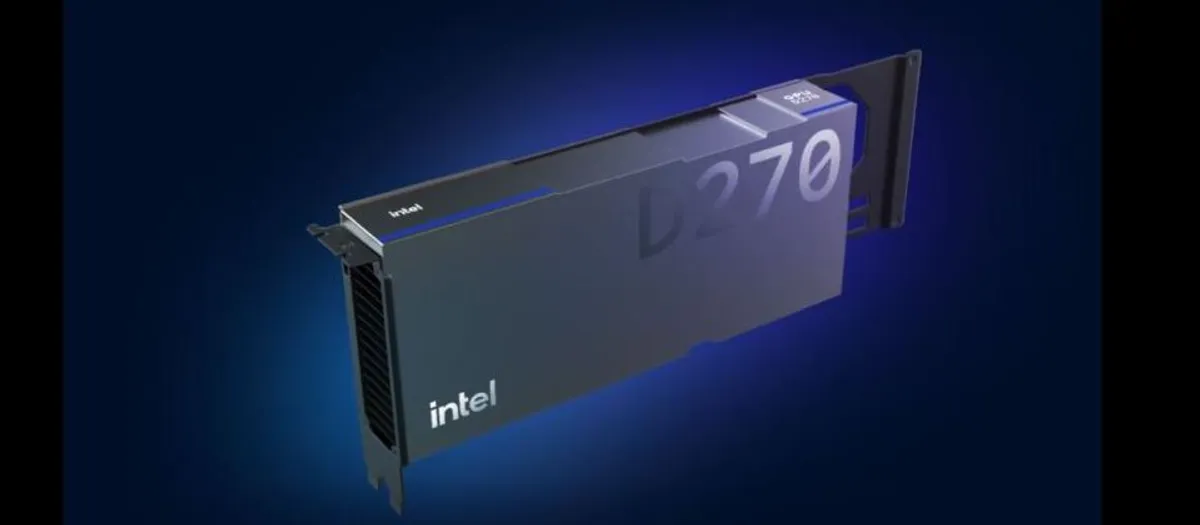
GPU D 系列代號 Crescent Island,專為 AI 推論設計,採用 Xe3P 架構。在 350 瓦的功耗下,最高可提供 480GB 的 LPDDR5X 記憶體、1.5TB/s 的記憶體頻寬,以及 1.3 PFLOPS 的 FP8 運算效能,主要鎖定大型語言模型推論、長上下文(Long Context)與多租戶 AI 服務等工作負載。
單張 GPU D 系列最高可支援約 3,000 億參數的模型;由 8 張 GPU 組成的系統,則能支援超過 1 兆參數的模型。英特爾同時強調,這款 GPU 採用標準 PCIe 介面與氣冷式設計,不需要專用的機櫃或液冷系統,可以直接部署在既有的資料中心,主打降低企業建置 AI 推論的成本與門檻。
同步亮相的 Xeon 機櫃設計,採用 Open Rack v3(ORv3)標準。部分 Xeon 6+ 配置可以在單一機櫃部署超過 4.6 萬個 CPU 核心,整體功耗約 133.45kW,以提高通用運算密度,支援大規模代理式 AI 的部署。英特爾在會場也展示了與不同業者合作的 Xeon 機櫃,專為代理 AI 的基礎架構設計。
軟體方面,GPU D 系列採用共通的 Xe 軟體架構,支援不同 Intel GPU 平台之間的應用程式轉移,並支援主流 AI 框架、推論服務引擎與開發工具,讓開發人員可以在 Xeon 處理器與 GPU 之間部署相同的工作負載。此外,英特爾介紹了 Intel AI for Enterprise Agent Toolkit,支援程式開發代理、企業工作流程與多模態 AI 應用,未來也會延伸到 Intel GPU 平台,提供跨 CPU 與 GPU 的異質運算能力。
在硬體標準方面,英特爾與其他業者合作展示 Open Adapter Card 標準,要建立機櫃內部署加速器卡的標準化規格,提升不同廠商在機構設計、電力與管理介面的互通性,讓企業能在既有基礎架構上逐步導入 AI 加速器,不需要重新建置新的資料中心。
英特爾資料中心系統與解決方案事業群副總裁 Nicolas Dubé 表示,開放模型讓企業擁有更多 AI 部署選擇,但要充分發揮代理式 AI 的能力,必須依據不同工作負載配置最適合的運算資源。他為此提出「Put Every AI Task in Its Place」的概念,也就是把每一個 AI 任務放在最適合它的位置。
英特爾認為,在代理 AI 架構中,GPU 主要負責大型語言模型推論與 Token 生成,而 CPU 則負責協調 AI 代理的工作流程,包括資料處理、I/O 管理、工具呼叫、資料傳輸與工作負載調度,讓 GPU 持續維持高使用率。隨著代理式 AI 導入更多的企業流程,CPU 將重新成為 AI 基礎架構的重要組成。
相較於生成式 AI 以大型語言模型推論為主,英特爾指出,代理式 AI 的工作流程更加複雜,不僅包含模型推論,還涉及資訊檢索、推理、工具呼叫、工作流程協調與任務執行等多個步驟。因此,資料中心不再只是追求 GPU 算力,而是需要 CPU、GPU 與專用加速器共同分工。
英特爾進一步指出,未來資料中心衡量效能的指標,將不再是單一 GPU 的效能,而是在符合延遲要求的前提下,單一機櫃可以同時支援多少 AI Agents 運作。這個觀點把評估的視角從單一晶片拉高到整個機櫃的系統層級。
目前 Intel GPU D 系列已經開始提供樣品。英特爾表示,會持續擴展 GPU、Xeon、開放式軟體與 OCP 生態系,目標是讓企業在既有的資料中心環境中,以成本效益與能源效率來部署代理 AI 推論應用。
關鍵數字
480GB:單張 GPU D 系列最高搭載的 LPDDR5X 記憶體容量,搭配 1.5TB/s 記憶體頻寬,支撐長上下文推論所需的資料吞吐量。
1.3 PFLOPS:在 350 瓦功耗下提供的 FP8 運算效能,是衡量這款推論 GPU 效能的關鍵指標。
3,000 億參數:單張 GPU 可支援的模型規模上限;8 張 GPU 組成的系統則可支援超過 1 兆參數的模型。
4.6 萬核心:部分 Xeon 6+ 配置在單一機櫃可部署的 CPU 核心數,整體功耗約 133.45kW,反映通用運算密度的提升。
350 瓦:GPU D 系列的功耗設計點,搭配標準 PCIe 介面與氣冷設計,降低企業在既有資料中心的導入門檻。