「案件這麼多,又不讓我用AI,要我怎麼辦?」這是法務部官員在8月底數位政府高峰會上說出的心聲。卷宗充滿個資與偵查細節,不能上傳商用AI;但年案件量超過1,600萬件,人工處理幾乎喘不過氣。法務部的解法是自己打造一套AI。
壓力來自數字。法務部及所屬共有127個機關,2025年刑事案件265萬件、行政執行案件1,358萬件、觀護受理案件突破12.5萬件,加總超過1,600萬件。每份案件都要人工閱讀卷證、查找前科、登打系統,重複性工作占第一線人員三成以上工作時間。
為何不用現成的商用AI?官員點出兩大顧慮:資料安全(偵查與觀護資料記載個資與辦案細節,去掉姓名仍可能透露案情),以及商用模型未必理解台灣法律用語、檢察書類或實務脈絡。因此法務部要自己掌握資料、模型選擇與部署方式,在可控、隔離的環境中運作。
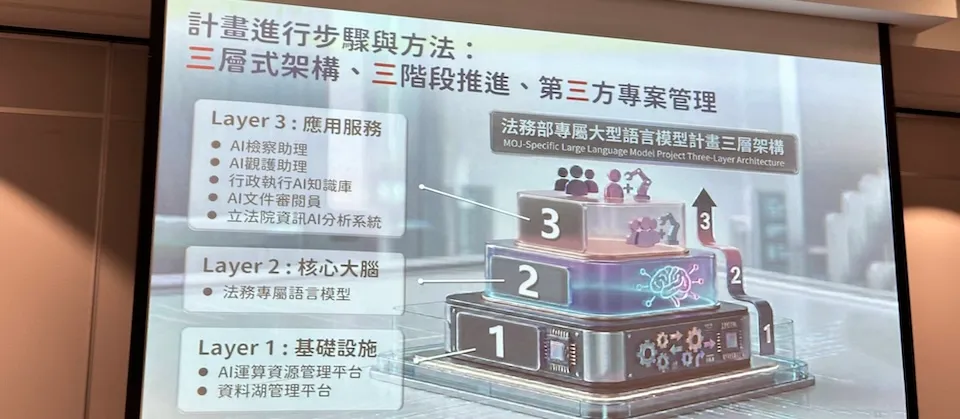
這項計畫名為法務專屬大型語言模型計畫,分三層:底層共用算力池與資料湖,中層法務專屬模型推論系統,上層自主開發的AI助理應用。2026年試驗期先選定代表性場域;2027年推廣期擴增本土司法語料與實務案例;2028年進入優化期。
底層先打地基。算力池的目標是支援1,200億(120B)以上參數的大型語言模型,具備150人同步上線的推論能力;資料湖集中管理結構化與非結構化資料,讓資料來源、流向與使用情形可追溯。
中層是整套系統的大腦。法務部希望模型不只懂繁體中文和台灣法律,還要理解檢察機關如何處理案件。團隊要建立封閉語料庫,除了辦案工具與法律書籍,也希望蒐集檢察官製作的起訴書、不起訴處分書。
原始案件資料不能未經處理就拿去訓練。法務部得先找出具代表性的高品質案例並去識別化,避免模型記住個人資料,被有心人用提示詞套出前科。計畫第一年還要測試Gemma 4、Mistral Large 3等開源模型,並建立自己的評測資料集,避免被單一模型綁定。
最上層是第一線會用的工具,第一波聚焦兩款。檢察官AI助理:以OCR讀取卷證、製作摘要,從裁判書擷取前科自動帶入系統;類型化的案件還能協助撰寫書類初稿。觀護AI助理:規劃以語音辨識將訪談錄音轉成文字,輔助製作觀護紀錄與風險評估報告。
AI的定位被畫得很清楚:「它是文字的表述,它不是幫你做決定。」AI不能替檢察官認定事實、適用法律或作成處分,初稿必須經過檢察官審核,責任仍在檢察官身上。法務部預期這些應用能將文書處理時間減少30%,但AI紀錄該保存多久,目前還沒有答案。