生成式人工智慧的發展正邁入全新分水嶺。隨著產業焦點由「模型訓練」轉向講求即時反應的「代理人AI」,AI資料中心正迎來結構轉型——朝向區域化、中小型化與極致低延遲的邊緣架構挺進。這場變革的領航者,是一家名為Vector Core Compute的新創算力商。
這家由美國頂級私募基金Vista Equity Partners與創投Cambium Capital聯手催生的新創公司宣布,將在三年內斥資35億美元,全面導入AI晶片獨角獸SambaNova的運算架構,在全美50個主要都會區建設中小型邊緣資料中心。
過去兩年間,CoreWeave、Nebius等新興雲端服務商靠著大舉搜刮輝達高階GPU,在遠郊興建數百MW的巨型資料中心一戰成名。市場一度相信,越大、越集中的算力園區,就越有競爭力。
然而隨著焦點轉向代理人AI,這套「超大園區迷思」開始鬆動。代理人系統需要自主拆解任務、多輪反覆推理並即時調用工具,若將數據傳往偏遠的超大規模算力中心,網路往返延遲將毀掉即時互動體驗。
這正是推動資料中心走向微型區域化的關鍵:代理人AI的運算特性,決定了算力必須離使用者更近,延遲必須壓到最低。
與市場盲目追逐吉瓦級超級園區的作法截然不同,Vector Core Compute聚焦於美國50個主要都會區,建設僅5至20MW的中小型邊緣資料中心,將算力直接推至企業與終端使用者的「家門口」。
都會周邊電網難以負荷巨型算力怪獸,但5到20MW的中小型站點不僅容易取得電力與現成物業改建,建設週期更短,更能規避「大型專案規模經濟失靈」的財務陷阱。
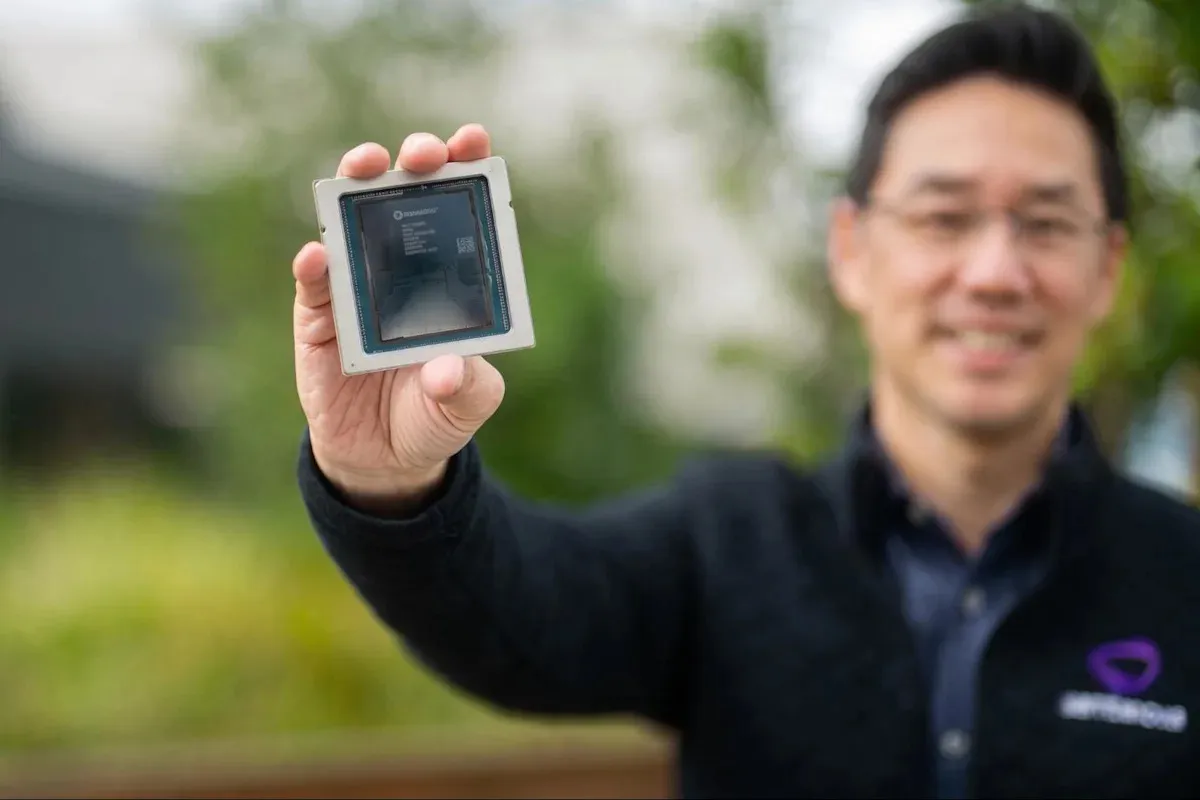
在這套全新邊緣雲架構中,SambaNova自研的「可重構資料流單元(RDU)」晶片扮演了核心樞紐角色。
當前大語言模型推理分為「Prompt預填」與「Token生成」兩階段。在Vector Core Compute的異質運算叢集中,預填工作交由擅長高度並行的輝達Blackwell GPU處理,而關鍵的生成解碼重任則由SambaNova RDU全權接管。
目前部署的是SN40晶片,隨後將升級至次世代SN50,解碼效能可望再上一層樓。
SambaNova的RDU架構具備獨特的資料流管線與多層級記憶體設計,大幅突破了傳統GPU逐字解碼時頻繁存取記憶體的頻寬瓶頸。
其解碼速度大幅超越傳統晶片,能將當前業界每秒60至150字的產出標準,推升至每秒400字以上的高速境界。
此外,SambaNova系統具備輕量與風冷散熱特性,能直接安裝於現有都會區既有建物,無需耗費巨資改造水冷管線。這正是邊緣站點得以快速落地的硬體基礎。
35億美元:Vector Core Compute三年內投入的總金額,全數用於導入SambaNova運算架構,顯示新創算力商押注邊緣推理的決心。
50個:計畫涵蓋的美國主要都會區數量。算力不再集中於偏遠郊區,而是部署在使用者的「家門口」,用距離換取延遲。
5至20MW:新建邊緣資料中心的規模區間。相較於動輒數百MW的巨型園區,小型站點更容易取得電力與現成物業,建設週期也更短。
每秒400字以上:SambaNova系統的解碼產出速度,遠高於業界每秒60至150字的標準。對需要多輪即時互動的代理人AI而言,這是體驗的分水嶺。
SN40到SN50:SambaNova RDU晶片的世代交替。現行SN40負責解碼運算,次世代SN50接棒後,邊緣叢集的推理效能可望再上一層樓。
從超大集中走向區域邊緣,AI算力正由「少數超級電廠」轉變為遍佈各大城市的「分布式配電網」。這不僅是規模的縮小,更是商業邏輯的翻轉:過去比的是誰的園區更大、GPU更多,未來比的是誰離使用者更近、反應更快。
對輝達而言,這波轉向未必是壞消息——預填階段仍由Blackwell GPU擔綱。但對專攻推理的晶片新創來說,邊緣化浪潮打開了一扇過去被巨型園區擋住的門。
隨著Vector Core Compute於洛杉磯的首座資料中心正式商轉,並加速進軍芝加哥、西雅圖等地,這波以低延遲邊緣網路為核心、由專用推理晶片驅動的新興雲端革命,正重新改寫全球AI基礎設施的競爭版圖。接下來值得觀察的是:50個都會區的建置進度能否跟上,以及更多雲端業者是否跟進這套「小而近」的路線。