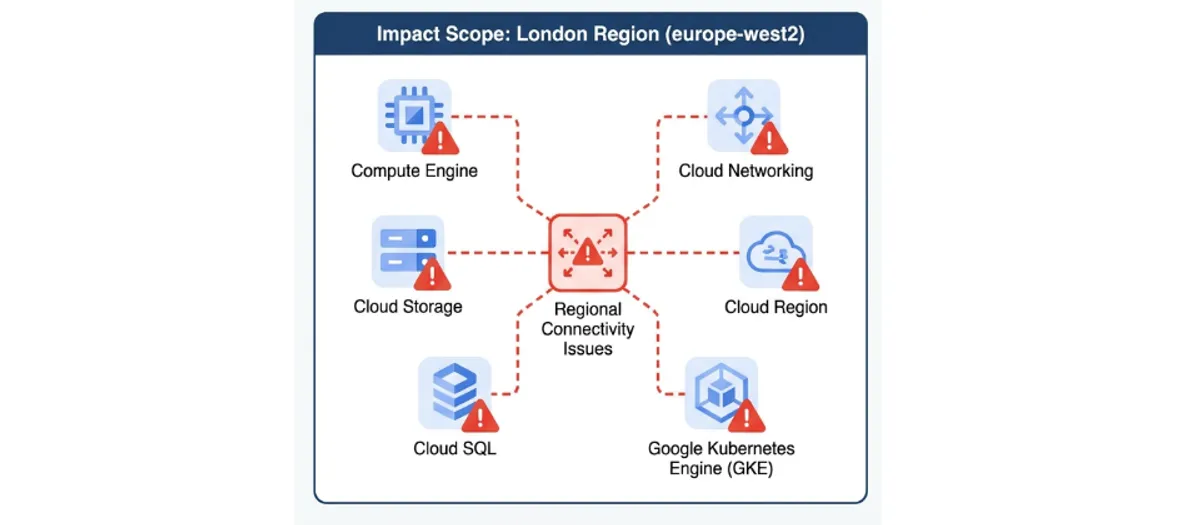
雲端服務中斷的影響,可以在一夜之間從機房蔓延到每個人的日常生活。Google Cloud在10月20日出現大規模服務異常,影響範圍集中在英國倫敦的europe-west2雲端服務區域。從英國夏令時間當天上午7時8分事故發生,到下午3時服務恢復,整起事件歷時7小時52分鐘,期間多項服務出現錯誤率升高及網路連線間歇性故障,連帶波及英國多家銀行、醫療與郵政等公共服務。
Google將這起事故的原因描述為「電力事件」。在雲端運算的世界裡,電力是資料中心最基礎的命脈,即便是Google等級的業者,一旦區域性的電力供應出現問題,影響也會在短時間內擴散到該區域承載的所有服務。這次受影響的europe-west2區域,共有38項服務受到波及。
受影響的服務清單涵蓋了雲端運算的核心項目,包括BigQuery Data Transfer Service、Cloud Filestore、Cloud Run、Google App Engine、Google Cloud NetApp Volumes、Google Kubernetes Engine,以及Managed Service for Apache Kafka等。從資料處理、檔案儲存、應用程式託管到容器調度,幾乎是企業上雲會用到的全套服務,這也解釋了為何下游的影響如此廣泛。
最直接感受到衝擊的是英國的公共服務。英國國民保健署(NHS England)與皇家郵政(Royal Mail)都在波及名單上。有病患向媒體表示,事故期間無法透過NHS的應用程式向醫院預約掛號。醫療預約系統的中斷,看似只是不便,但在分秒必爭的醫療場景中,任何系統停擺都可能帶來實質風險。
金融業的災情同樣慘重。數位銀行Revolut、匯豐銀行(HSBC)、萊斯銀行(Lloyds)以及房地產網站Rightmove,都傳出受到影響。其中Revolut在事故期間曾表示部分服務受到影響,信用卡付款與ATM提款暫時無法使用。對一家主打數位體驗的銀行來說,支付與提款功能同時停擺,對用戶信心的打擊不容小覷。
把這起事故的關鍵數字整理如下:
7小時52分鐘,事故總歷時。從上午7時8分到下午3時,橫跨整個上午的營業時間,正是企業與民眾最依賴雲端服務的時段,衝擊因此被放大。
38項,europe-west2區域受影響的服務數量。這不是單一服務故障,而是整個區域的基礎設施事件,代表問題出在比單一軟體更底層的環節,與Google所稱的電力事件說法一致。
至少6家,公開傳出受到波及的英國企業與機構,包括NHS England、Royal Mail、Revolut、HSBC、Lloyds與Rightmove,橫跨醫療、郵政、金融與房地產四大領域。
0,這是一般企業在面對這類事故時能做的事:幾乎為零。當雲端業者區域性中斷,租用該區域服務的企業只能等待修復,這也是近年「多區域部署」與「多雲策略」越來越受重視的原因。
把時間軸拉長,這並非Google Cloud第一次發生區域性事故,但電力事件導致近八小時中斷,在近年仍屬少見。雲端業者通常會在資料中心部署不斷電系統與備用發電機,這次電力事件能持續影響近八小時,代表問題的層級超出常規備援機制能夠涵蓋的範圍,具體的技術細節有待Google後續公布完整的事後檢討報告。
對台灣企業的啟示在於,雲端服務的集中化是一把雙面刃。把核心系統放在單一雲端區域,雖然管理方便、成本較低,但一旦該區域發生基礎設施等級的事故,業務就會全面停擺。近年越來越多企業開始採用跨區域備援,甚至同時使用多家雲端業者的服務,分散單點故障的風險。這起倫敦區域的中斷事件,正好為這種策略提供了最新、也最昂貴的例證。
後續值得關注的是Google是否會公布更詳細的事後檢討,說明電力事件的具體成因,以及europe-west2區域的備援機制為何未能更快接手。同時,受到波及的銀行與公共服務業者,是否會因此調整其雲端部署策略,也值得持續追蹤。對使用者而言,這起事件再次提醒:再穩定的雲端服務,也可能有中斷的一天,重要服務最好保留備用的使用管道。