OpenAI 公開了一套名為 MultiLangBench 的程式開發基準測試,要檢驗 AI 能不能使用二十種程式語言,從頭建立一個與 SQLite 相容的資料庫引擎。這套測試特別納入了 COBOL、Fortran 等老牌語言,直指企業老舊系統維護的痛點。
對開發者而言,這套基準測試提供了一個統一的比較標準,可以衡量不同模型在各種程式語言上的軟體開發能力與進展。
測試涵蓋的二十種語言,包括 COBOL、Fortran、Visual Basic 這類可供 AI 學習的程式碼與文件較少的語言,也包括 Python、Java 及 Rust 等熱門語言。
OpenAI 指出,COBOL、Fortran 及 Visual Basic 等語言,能讓模型學習的程式碼與文件少於 Python 等熱門語言。過去也有開發者反映,AI 在處理這類語言時容易遇到困難。
這正是測試設計的用意:不少企業的系統已經運作數十年,部分至今仍使用 COBOL 等較早期的程式語言。
當企業要維護或改寫這些老舊系統,可能遇到原始開發人員離職、說明文件不完整等問題,有些業務規則甚至只保存在程式碼之中,沒有其他地方可以查證。
AI 理論上可以協助程式維護及跨語言移植,但前提是必須理解既有的業務規則,避免改寫之後改變了原本的計算結果與資料處理方式。
測試方法上,MultiLangBench 選擇 SQLite 三點四零點一版本作為共同測試題目,要求模型參考提供的文件,用指定語言自行寫出能處理資料庫操作的程式。
基準測試會提供原始資料庫,以及資料查詢與修改指令,讓模型寫出的程式實際執行,再透過原版 SQLite 確認處理結果是否正確。
為了防止取巧,測試環境禁止上網,也會移除既有的 SQLite 軟體,避免模型直接調用現成程式交差。
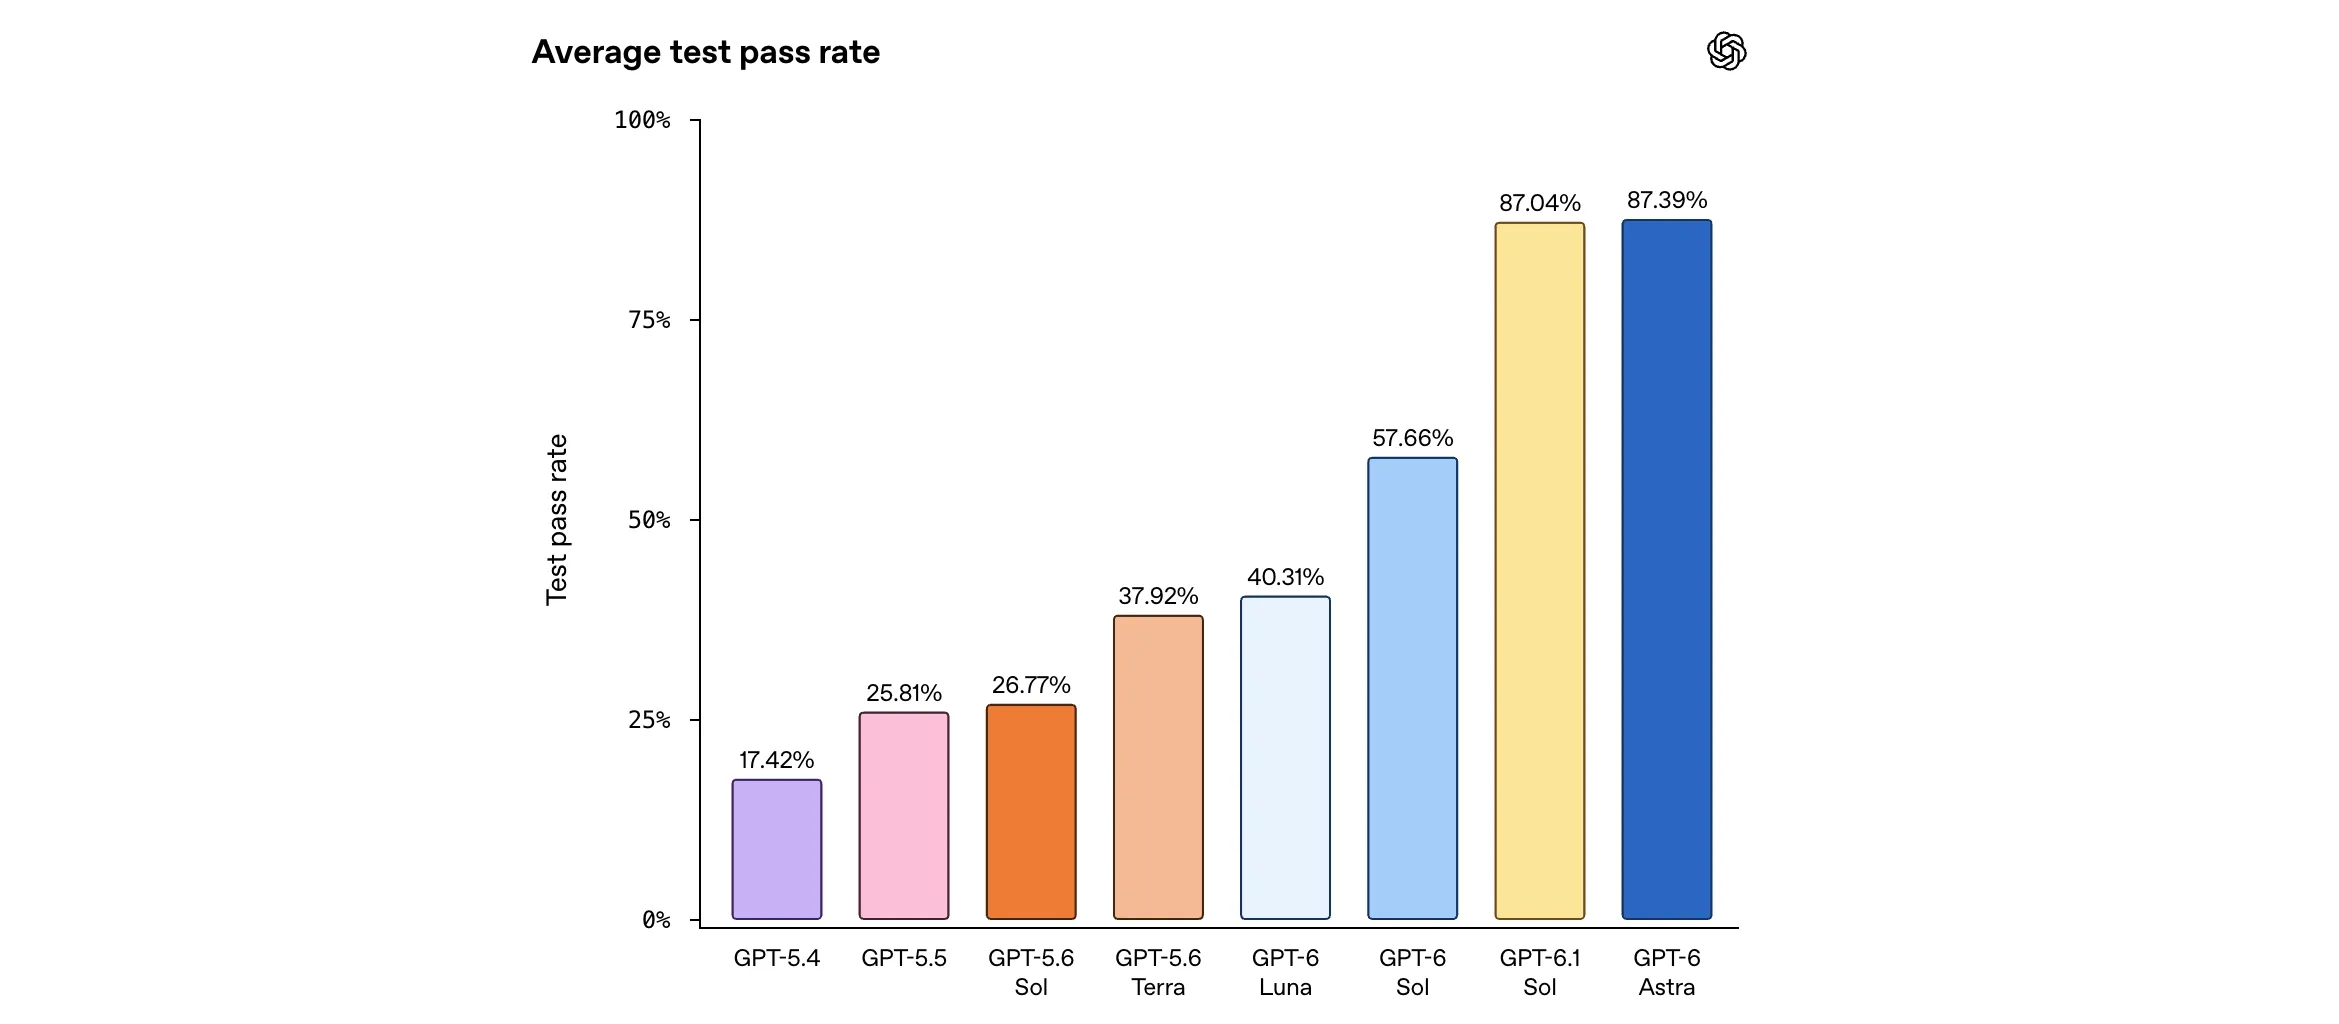
OpenAI 以 GPT-6 Astra 等模型進行評測。在最高推理強度下,Astra 在二十種語言的平均測試通過率達到 87.4%,高於 GPT-5.6 Sol 的 26.8%。
即使是表現最好的模型,COBOL 依然是難關:Astra 在 COBOL 的通過率為 72.1%,是二十種語言中表現最低的一個,顯示冷門語言的資料稀缺確實影響了模型的發揮。
除了從頭開發,OpenAI 另外設計了 COBOL 改寫評測,專門檢驗既有程式的跨語言移植能力。
這項評測要求模型把 COBOL 程式轉換成 C++、Java、Kotlin、Python 或 Rust,並且改寫後的輸出必須與原程式完全一致。
標準相當嚴格:例如 COBOL 的金額運算如果原本是直接捨去多餘小數,改寫時卻改成四捨五入,即使程式能正常執行,也不算正確。
在這項改寫評測中,GPT-6.1 Sol 以較低的推理強度,取得了 86.6% 的準確率。
從企業的角度來看,這套測試回應了一個存在已久的難題:核心系統的老程式該由誰來接手維護。原始開發人員可能已經離職,說明文件可能並不完整,而業務規則只保存在程式碼裡。
AI 若能可靠地理解並改寫這些老程式,確實可以協助程式維護及跨語言移植;但正如評測所堅持的,改寫結果必須分毫不差,不能改變原本的計算結果與資料處理方式。
這套基準測試把「AI 能不能寫冷門語言的程式」變成可以量化的指標。對企業技術決策者來說,未來在評估 AI 輔助老系統更新時,終於有公開可驗證的數據可以參考。
目前 MultiLangBench 已在 GitHub 公開基準測試設定與測試資料,供開發者檢查及使用,後續各家模型的成績變化值得持續關注。
關鍵數字
測試語言:20 種,包含 COBOL、Fortran、Visual Basic 等冷門語言,以及 Python、Java、Rust 等熱門語言;測試題目為 SQLite 3.40.1,要求從頭寫出相容的資料庫引擎。
模型成績:GPT-6 Astra 平均通過率 87.4%,其中 COBOL 僅 72.1% 為最低;GPT-5.6 Sol 平均 26.8%;COBOL 改寫評測中,GPT-6.1 Sol 以較低推理強度拿下 86.6% 準確率。
解讀:數據呈現兩個訊息。第一,即使是最強的模型,在冷門語言上的表現仍明顯落後,資料稀缺確實是瓶頸;第二,跨語言改寫的準確率已接近實用水準,企業老系統的 AI 輔助移植,正從概念走向可行。