5 點看懂
第一,AWS 推出 PyTorch 擴充套件 TorchNeuron,目標是讓開發者更容易把既有模型搬到自家 Trainium 晶片上執行。
第二,過去轉換晶片需要配合特定的編譯與執行方式調整程式,現在通常只需調整指定的運算裝置,就能維持原有流程。
第三,擴充套件支援逐項執行與編譯執行兩種模式,可以分開用也可以搭配,兼顧除錯彈性與執行效率。
第四,開發者可以繼續使用熟悉的 PyTorch 測試、除錯與分散式訓練工具,不必重學一套。
第五,目前還是公開測試版,尚未支援所有功能,部分舊程式轉移時仍需手動調整。
AWS 釋出了 AI 開發框架 PyTorch 的擴充套件 TorchNeuron,讓開發者更容易改用 AWS 自家的 AI 加速晶片 Trainium 來執行既有模型。
PyTorch 是開發 AI 模型常用的框架,無論是讓模型從大量資料中學習,還是用訓練完成的模型產生文字、語音等結果,都離不開它。
過去 AWS 已經提供讓 PyTorch 模型使用 Trainium 的方法,但開發者必須配合特定的編譯及執行方式調整程式,原本用於其他晶片的工作流程不一定能直接轉換,搬遷成本不低。
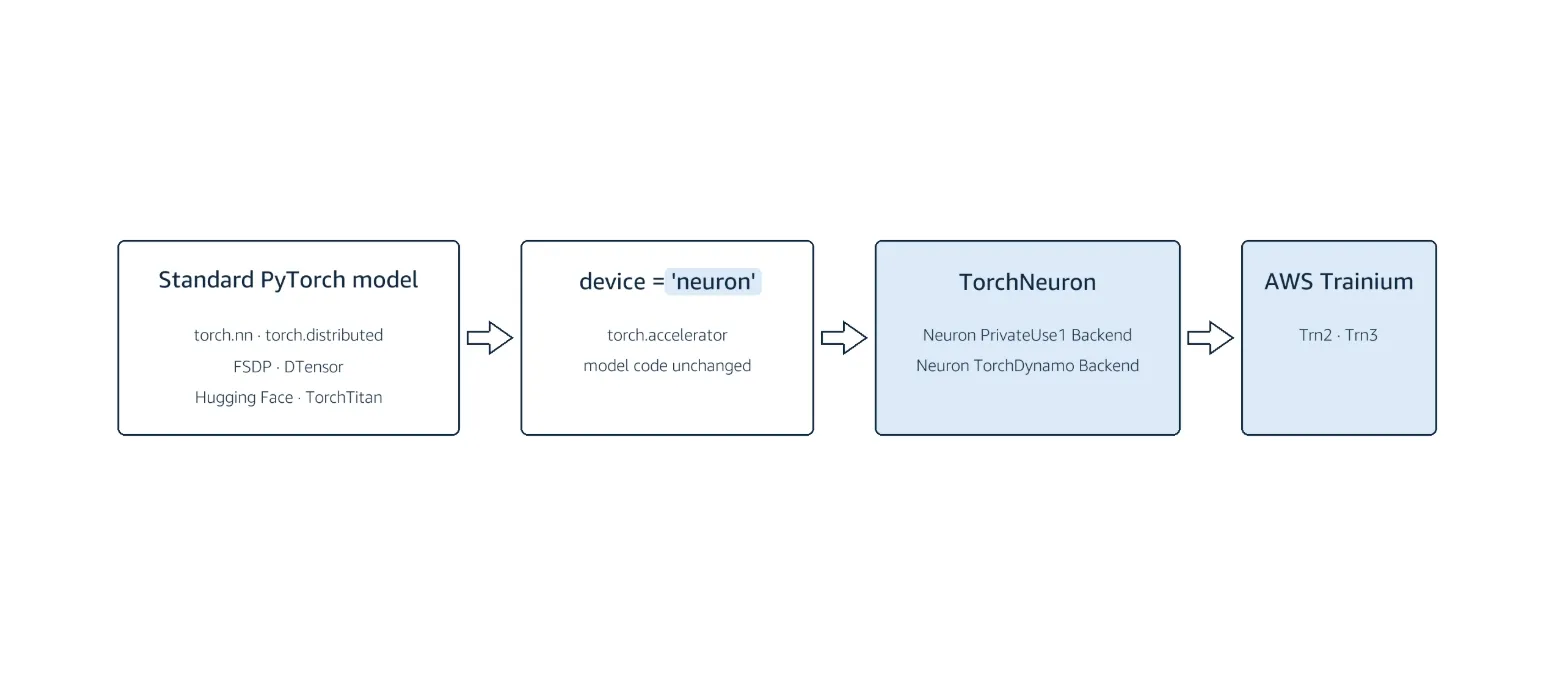
TorchNeuron 的做法是改用 PyTorch 既有的硬體支援機制,讓 PyTorch 直接辨識 Trainium。用戶只要在程式中指定由該晶片負責運算,不必另外改用一套不同的模型執行方式。
在使用受支援的模型與功能時,開發者通常只需要調整程式指定的運算裝置,就能維持原有的訓練與推論流程,大幅減少更換晶片時的修改工作。
AWS 也表示,正與 PyTorch 社群合作,調整框架內與特定晶片綁定的程式碼,讓不同硬體能透過較一致的方式執行 PyTorch 模型。
工具鏈的延續性是這次更新的重點:開發者可以繼續使用 PyTorch 原有的測試與除錯工具,排查問題的方式不用改變。
對於規模較大的模型,也能使用 PyTorch 既有的分散式訓練工具,把訓練工作分配到多顆 Trainium 晶片上處理。
執行模式上,TorchNeuron 支援兩種方式。逐項執行模式會在程式運作時個別編譯每一項運算,方便開發者檢查中間結果,但每項運算分別編譯、啟動,可能增加額外耗時。
另一種是編譯執行:開發者可使用 PyTorch 的 torch.compile 功能,在首次執行時把多項運算編譯成 Trainium 可執行的程式,之後執行相同條件的運算時,就不必重新編譯。
兩種模式也能搭配使用,只針對模型中需要加快處理的部分進行編譯,其餘維持逐項執行的彈性。
不過,TorchNeuron 目前仍處於公開測試階段,尚未支援所有的 PyTorch 功能,導入前需要評估相容性。
在逐項執行模式下,未支援的運算可能改由中央處理器執行;在編譯模式下,則可能導致編譯失敗。
此外,輸入資料的大小或每次處理的筆數改變時,也可能需要重新編譯;如果程式原本使用的是 Trainium 舊版專用介面,改用 TorchNeuron 時仍須調整,並非所有程式都能直接轉移。
對已經在 AWS 上訓練模型的團隊來說,這個擴充套件降低了嘗試自家晶片的門檻。過去換晶片往往牽動整套執行流程,現在有機會只改裝置參數就先跑跑看,試錯成本大幅下降。
對企業的機器學習團隊而言,這類擴充套件的另一層價值在於降低硬體綁定的風險。過去一旦把訓練流程綁定某家晶片的專用介面,日後想換硬體就得重寫;TorchNeuron 走 PyTorch 原生硬體支援機制的路線,讓同一套程式碼更容易在不同晶片之間搬移。
另一個值得注意的細節,是 AWS 與 PyTorch 社群的合作方向:調整框架內與特定晶片綁定的程式碼。這意味著未來不只 Trainium,其他硬體也有機會透過較一致的方式被 PyTorch 支援,整個生態系的硬體選擇會變多。
目前 TorchNeuron 已推出公開測試版,支援 Trainium2 與 Trainium3。後續正式版的支援範圍與效能表現,將決定它能否真正成為開發者搬遷上 Trainium 的預設路徑。